La produttività di qualsiasi organizzazione dipende dalle prestazioni dei computer dei propri dipendenti.
Se tali computer funzionano a rilento o si bloccano, la produttività dei dipendenti ne risentirà e l’agilità complessiva dell’organizzazione subirà un calo.
Data l’entità dei rischi in gioco, il monitoraggio delle prestazioni rappresenta una funzionalità fondamentale per qualsiasi organizzazione interessata a valorizzare al massimo il proprio personale e la propria tecnologia.
Di seguito sono riportate sette best practice per garantire che la soluzione della Sua organizzazione monitori in modo efficace ed efficiente le prestazioni degli endpoint , quali i computer dei dipendenti, i server e altri dispositivi.
1. Monitorare ogni tipo di endpoint
Si è tentati di mantenere le cose semplici. Supponiamo che il 90 % degli endpoint della vostra organizzazione sia costituito da computer c Windows . Si investe in strumenti e si definiscono procedure per il monitoraggio di tali macchine Windows .
Certo, esistono Linux server, ma non si trovano nelle postazioni di lavoro né negli uffici domestici delle persone. E alcuni dirigenti adorano i propri Mac. Dovrete fidarvi del fatto che quelle macchine funzionino bene; dopotutto, nessuno si lamenta. E disponete di numerosi grafici che dimostrano l’ottimo lavoro che state svolgendo con le macchine Windows .
Ma anche gli altri endpoint sono importanti. E quando si verificano problemi di prestazioni, questi possono avere ripercussioni su un gran numero di altri utenti, direttamente o indirettamente. (Quando il sistema “ Mac ” del direttore finanziario va in tilt e questi non è in grado di approvare gli acquisti, molte persone ne subiranno le conseguenze.)
In ogni caso, si assicuri di disporre degli strumenti e delle procedure necessari per monitorare ogni tipo di dispositivo endpoint all’interno della Sua organizzazione: Windows, macOS e Linux.
2. Si prega di monitorare ogni endpoint (sì, ogni endpoint)
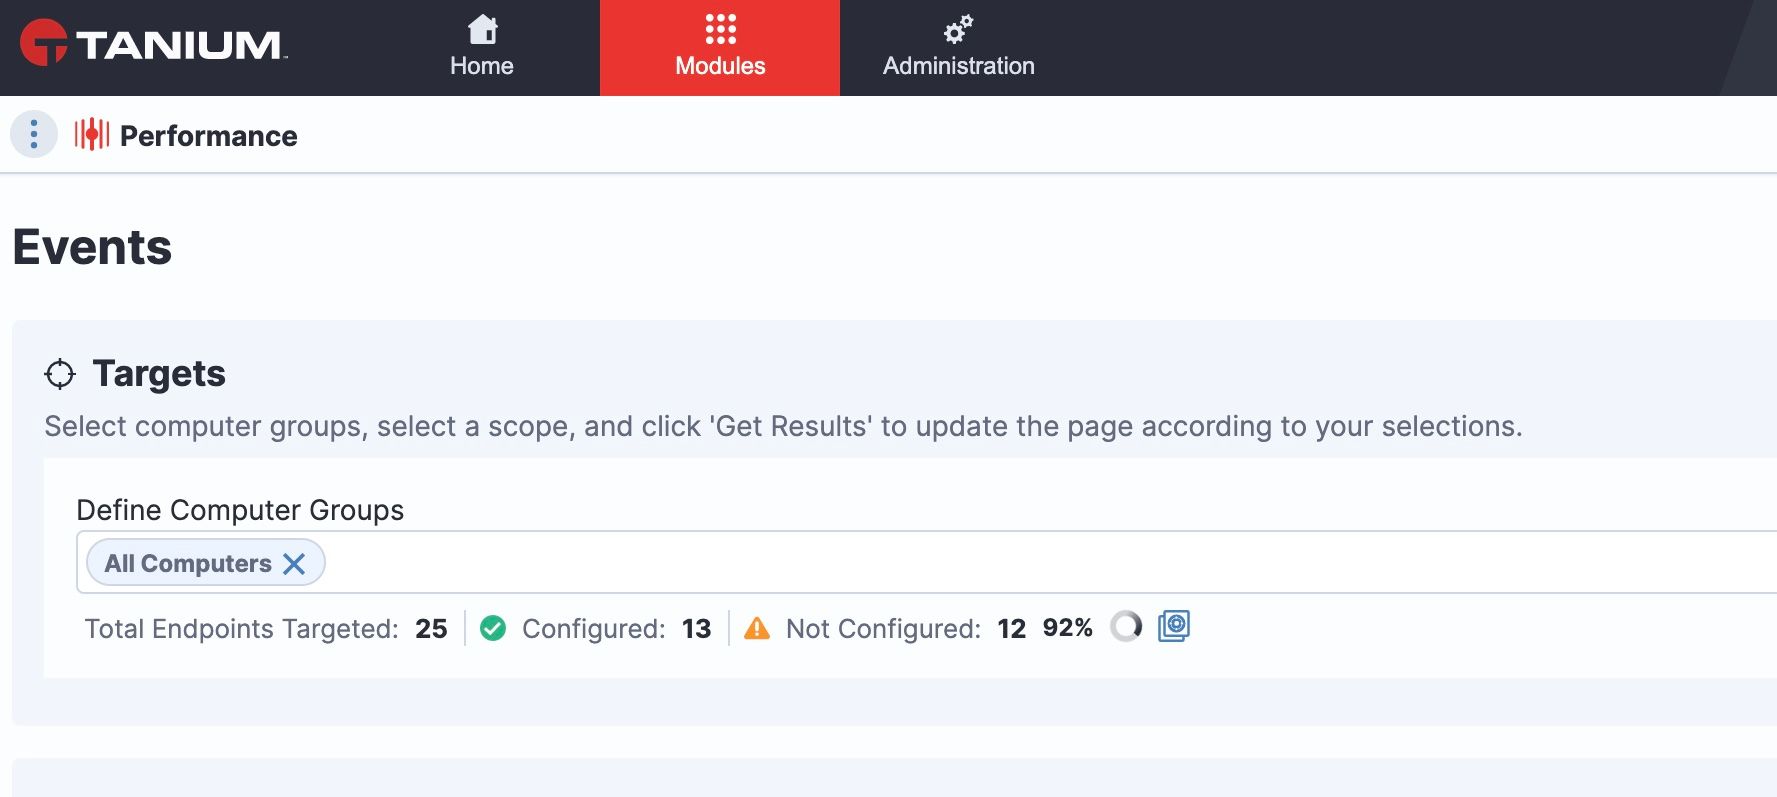
Anche se disponete di strumenti di monitoraggio per ogni tipo di dispositivo endpoint all’interno della vostra organizzazione, è probabile che alcuni — o molti — dei vostri endpoint vi sfuggano comunque. Lo dico perché, quando ci rechiamo presso le aziende per valutare le loro pratiche di monitoraggio delle prestazioni, riscontriamo solitamente che circa il 10-20 per cento degli endpoint non viene incluso nei rapporti di monitoraggio delle prestazioni.
Ciò significa che il 10-20 % degli endpoint è a rischio di prestazioni insufficienti, con la conseguenza che i dipendenti che li utilizzano si sentono frustrati e diventano meno produttivi.
In un modo o nell’altro, predisponete strumenti e procedure che vi consentano di monitorare effettivamente ogni endpoint all’interno della vostra organizzazione.
3. Abbiate una visione d’insieme
Trovare ogni endpoint è una cosa. Consentire ai responsabili IT e alle unità aziendali di avere una “visione d’insieme” di tutti gli endpoint gestiti è un’altra questione.
Un monitoraggio efficace delle prestazioni richiede spesso una visione d’insieme: quella panoramica che consente di constatare, ad esempio, che l’ufficio di Chicago sta funzionando bene, mentre a Cincinnati si verificano arresti anomali degli endpoint a causa di errori di memoria conseguenti all’aggiornamento dell’applicazione effettuato la notte scorsa.
Per monitorare le prestazioni a livello aziendale, si assicuri di poter ottenere una visione d’insieme dell’intera organizzazione, nonché un’analisi dettagliata di eventuali endpoint che presentano problemi di prestazioni.
4. Rendete il tutto semplice per gli utenti finali
In molte organizzazioni, quando un dipendente segnala un problema di funzionamento all’help desk, le interruzioni del suo lavoro sono solo all’inizio. La maggior parte delle piattaforme di monitoraggio delle prestazioni richiede che i tecnici informatici interrompano il lavoro dei dipendenti o entrino in conflitto con esso per risolvere il problema.
Il dipendente potrebbe dover accettare una richiesta di installazione di una nuova applicazione diagnostica o di controllo remoto sul proprio endpoint. L’analisi del problema potrebbe non poter avere inizio finché non si interrompa l’attività ufficiale, ovvero quella svolta nell’ambito delle mansioni lavorative del dipendente. Se il problema era intermittente e derivava dall’attività in cui era impegnato il dipendente, l’occasione ottimale per risolvere il problema è ormai sfumata.
Un approccio migliore? Utilizzate strumenti che consentano agli ingegneri di analizzare ciò che accade sull’ endpoint e senza interrompere l’utente. Consentite ai tecnici di monitorare i processi, l’utilizzo della memoria e altri dati fondamentali senza che il dipendente debba muovere un dito, installare un client, cliccare su finestre di dialogo o trascorrere un’ora al telefono.
5. Registrazione a livello locale, risoluzione dei problemi a livello globale
Uno dei motivi per cui così tante piattaforme di monitoraggio delle prestazioni ricorrono a tecniche di analisi invasive è che dispongono di un accesso limitato o nullo ai dati relativi all’attività dell’ endpoint , finché i tecnici non si connettono effettivamente agli endpoint tramite la rete.
Questo approccio presenta due principali limiti: interrompe gli utenti e limita i dati a cui gli ingegneri possono accedere. Se un problema è intermittente o in qualche modo correlato ad altre attività verificatesi nelle ore o nei giorni precedenti, è probabile che il tecnico incaricato dell’indagine non riesca a cogliere tali elementi.
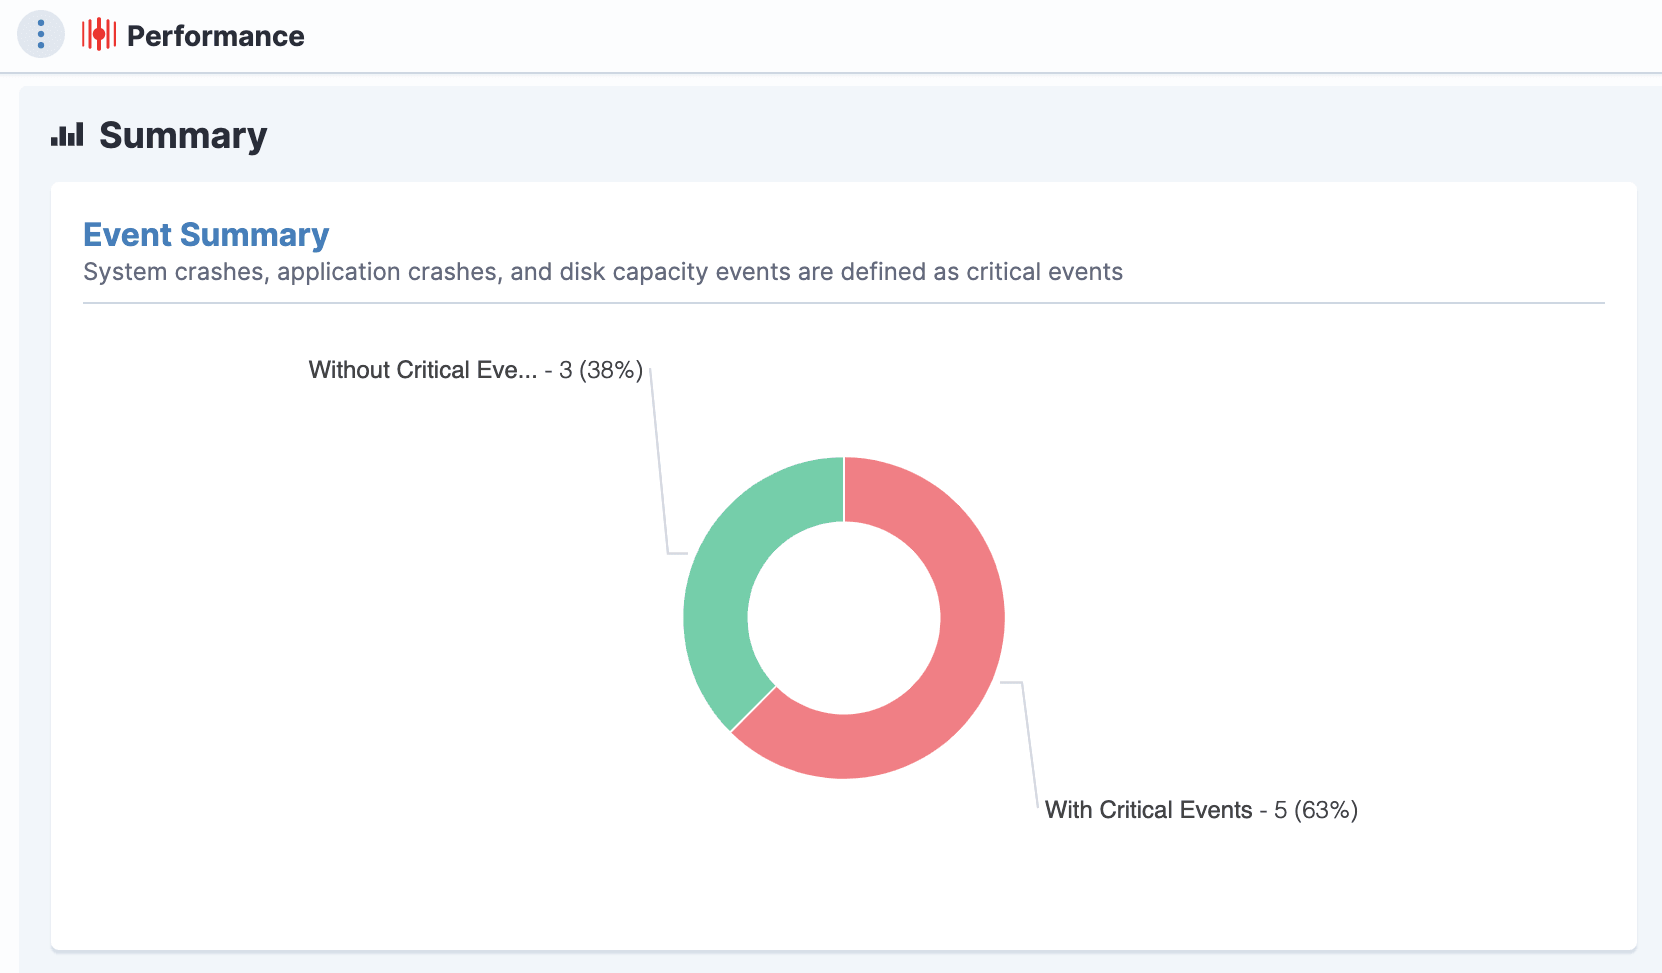
Un approccio alternativo consiste nel far sì che gli endpoint registrino i dati relativi alle prestazioni a livello locale, in modo che, quando i tecnici indagano sui problemi, possano trovare immediatamente una grande quantità di dati su cui basarsi in un archivio locale.
Poiché i dati sono già stati raccolti, gli ingegneri non devono interrompere gli utenti per acquisirli. Inoltre, poiché i dati vengono archiviati localmente, i tecnici possono accedervi senza che sia necessario che tutti gli endpoint trasmettano continuamente metriche dettagliate a una console di gestione centrale.
Tuttavia, anche in assenza di un’enorme mole di dati che causi congestione del traffico sulle reti, gli ingegneri possono risolvere i problemi dell’ endpoint da qualsiasi postazione: una LAN o una WAN locale, un centro di assistenza tecnica, un centro di controllo delle operazioni di sicurezza o persino un ufficio a domicilio.
Il risultato è una maggiore disponibilità di informazioni utili alla risoluzione dei problemi, una risoluzione più rapida degli stessi e interazioni più agevoli sia per gli utenti finali che per i tecnici.
6. Aiutate il team di sviluppo interno
Raccogliendo e condividendo informazioni dettagliate sulle prestazioni dell’ endpoint , un team addetto alle operazioni IT ha l’opportunità di aiutare il team di sviluppo interno a risolvere i problemi relativi alle applicazioni che sta sviluppando per i dipendenti.
I dati in tempo reale e storici relativi all’esecuzione dei processi, all’allocazione della memoria, all’utilizzo del disco e ad altre metriche chiave su centinaia o migliaia di endpoint possono aiutare gli sviluppatori a individuare e risolvere problemi che non sarebbero stati in grado di Detect o di caratterizzare adeguatamente in implementazioni più limitate in ambienti di test.
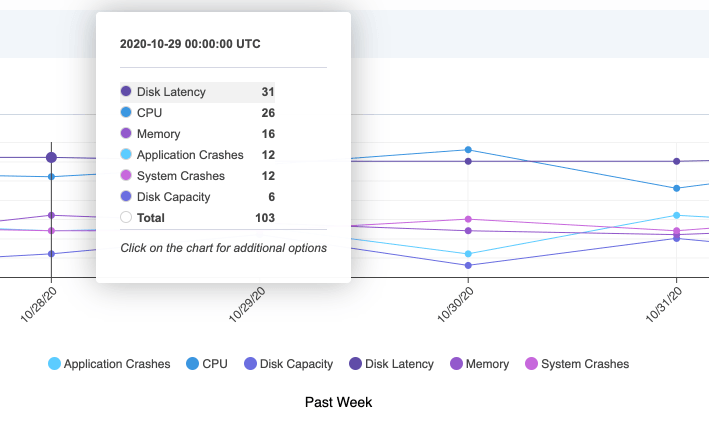
Performance Il monitoraggio potrebbe essere considerato uno strumento generico applicabile a ogni dipendente, ma rappresenta anche uno strumento prezioso per le organizzazioni di sviluppo, anche se non fa ufficialmente parte di una suite di sviluppo software.
7. Ridurre il tempo medio di riparazione (MTTR)
L'MTTR ( , tempo medio di riparazione) rappresenta forse il parametro di riferimento per eccellenza di qualsiasi pratica di monitoraggio delle prestazioni.
Quando si verifica un problema, in quanto tempo il team IT è in grado di risolverlo? Riusciscono a trovare le informazioni di cui hanno bisogno in modo rapido e semplice? Riusciranno a individuarlo senza disturbare i dipendenti coinvolti nel problema?
Il monitoraggio di indicatori come questi consente alle organizzazioni IT di valutare il valore dei propri strumenti e delle proprie procedure di monitoraggio delle prestazioni. Se il personale, i processi e la tecnologia che utilizzate per il monitoraggio delle prestazioni non riescono a ridurre l’MTTR, ciò indica che il vostro personale, i vostri processi e la vostra tecnologia necessitano ancora di supporto.
Seguendo queste best practice, potrete ridurre il tempo medio di risoluzione (MTTR), ottimizzare le prestazioni senza interferire con l’attività quotidiana dei dipendenti, aiutare i team di sviluppo interni a risolvere più rapidamente problemi complessi e beneficiare di una risposta più tempestiva alle vulnerabilità di sicurezza e ad altri rischi operativi.
Per saperne di più, consultate il mio precedente articolo sul blog e "10 modi in cui Tanium migliora il monitoraggio delle prestazioni".
Se siete pronti a vederlo in azione, richiedete oggi stesso una demo all’indirizzo .

