Sulla scia delle interruzioni di servizio su larga scala nel cloud e delle violazioni informatiche che bloccano completamente l’attività aziendale, i consigli di amministrazione e i vertici aziendali hanno continuato a sollecitare una maggiore resilienza informatica sia a livello aziendale che .
Una sfida costante in materia di resilienza consiste nel tenere il passo con avversari che agiscono alla velocità di una macchina e non rispettano alcuna regola. Secondo gli esperti di sicurezza informatica intervenuti questa settimana al RSAC 2026 di San Francisco, il modo migliore per colmare tale divario è l’antifragilità.
«Vogliamo sistemi in grado di autoripararsi, sistemi che si evolvano autonomamente.»Anthony Rodriguez, vicepresidente aggiunto responsabile dell’ingegneria della sicurezza delle applicazioni e della gestione delle minacce presso CVS Health
Nel corso della sessione “ ” , tenutasi il primo giorno dell’evento annuale del settore, è stato messo a confronto il concetto di resilienza, ovvero la capacità di resistere allo stress, con quello di antifragilità, in cui un sistema utilizza lo stress per migliorare, diventando così più resiliente. John Kindervag, chief evangelist presso Illumio — ed ex analista di Forrester, ideatore del modello zero trust — e Anthony Rodriguez, AVP responsabile dell’ingegneria della sicurezza delle applicazioni e della gestione delle minacce presso CVS Health, ha esortato i team di sicurezza informatica ad abbandonare il concetto di resilienza per orientarsi verso quello, più adattivo e proattivo, di antifragilità.
Perché la resilienza di non è più sufficiente
Una volta preso atto del fatto che gli hacker finiranno inevitabilmente per individuare i vostri punti deboli, è necessario instaurare una prassi che preveda di sottoporre intenzionalmente i vostri sistemi a sollecitazioni prima che siano gli hacker a farlo al posto vostro.
Kindervag ha fatto un paragone con il sollevamento pesi. Il corpo umano è un sistema antifragile e, quando si sollevano pesi, il corpo diventa più forte durante la fase di recupero. Lo sforzo fisico derivante dall’allenamento porta a risultati positivi e a una maggiore capacità di adattamento, purché vi sia equilibrio tra sforzo e recupero.
Nei sistemi informatici, il fattore di stress è un attacco o un incidente, mentre il motore di adattamento è zero trust. Kindervag e Rodriguez hanno affermato che la sicurezza informatica e l’ingegneria si stanno orientando verso uno stato di maggiore prontezza dinamica. Lo si può constatare in tutto il settore, man mano che i sistemi statici e reattivi si evolvono verso modelli proattivi e in tempo reale.
L'intelligenza artificiale sta sia aggravando i rischi legati alla sicurezza informatica sia aiutando gli ingegneri a mitigarli. «Vogliamo sistemi in grado di autoripararsi, sistemi che si evolvano autonomamente», ha affermato Rodriguez. «Le organizzazioni possono cogliere quegli stessi segnali ed evolversi più rapidamente. “La chiave sta nel saper cogliere i segnali e metterli a frutto.”
, di Kindervag, ha osservato che nessuno è disposto a spendere denaro o ad agire finché non si verifica un evento negativo, citando un dirigente che recentemente gli ha affermato che una multa di 150 milioni di dollari è solo un errore di arrotondamento. « dobbiamo fare in modo che i vertici inizino a interessarsi alla sicurezza informatica e smettano di aspettare che si verifichino eventi negativi », ha affermato Kindervag .
I due hanno illustrato il ruolo dell’intelligenza artificiale nel potenziare l’adattabilità dei sistemi e l’importanza di ridurre i processi manuali per rispondere meglio alle minacce sconosciute, nonché di integrare i principi del chaos engineering, che prevedono l’introduzione deliberata di fattori di stress nei sistemi al fine di individuare i punti deboli e migliorare la robustezza complessiva.
Ingegneria per il caos del mondo reale
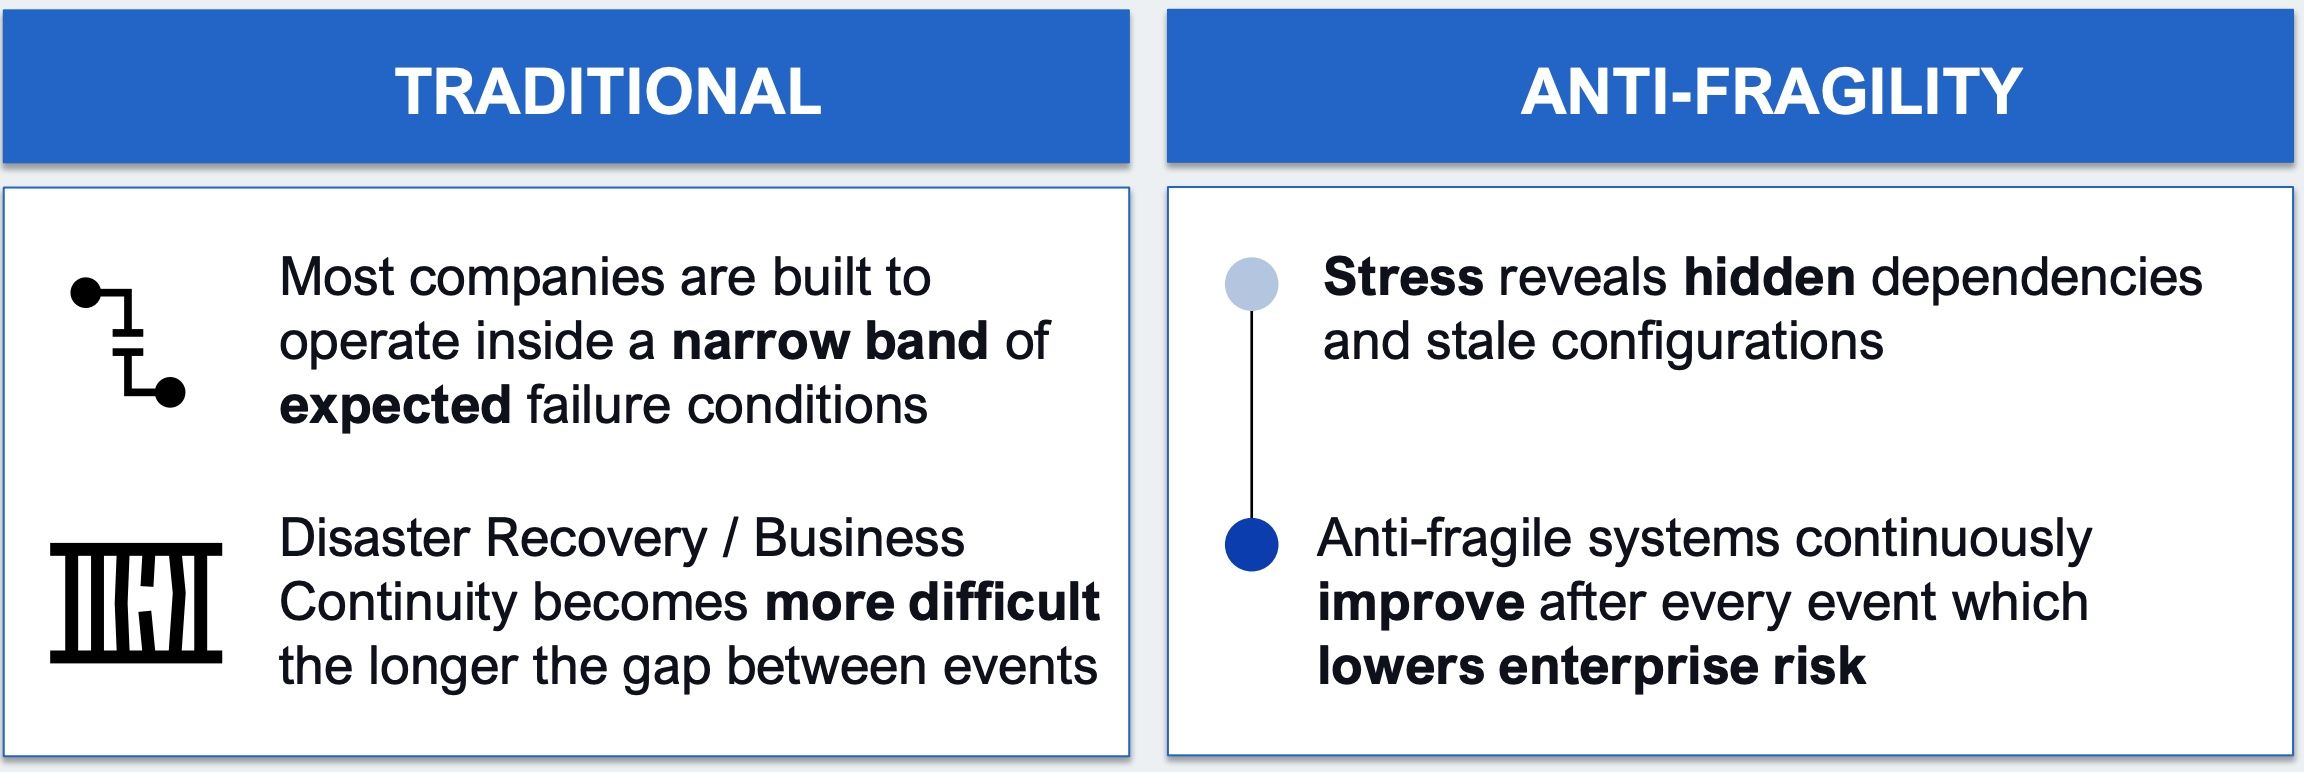
Hanno sostenuto che l’antifragilità dovrebbe essere un processo continuo, in cui le organizzazioni imparino da ogni incidente per prevenirne il ripetersi in futuro. Ciò significa andare oltre la logica del ripristino in caso di disastri e della continuità operativa. Per far evolvere i Suoi sistemi affinché funzionino con successo in condizioni di stress continuo, sostituisca le strategie standard del settore, lineari, di DR/BC, con l’introduzione del caos, al fine di tentare attivamente di mettere fuori uso il Suo ambiente di produzione.
«È meglio che vi preparate all’eventualità di un guasto… non a un guasto specifico che sperate si verifichi, ma che cerchiate continuamente di provocare… mettendo fuori uso i sistemi, sottoponendoli a traffico reale, simulando diversi scenari, semplicemente sottoponendo continuamente a stress l’ambiente e i team che lo supportano», ha affermato Rodriguez.
«Dobbiamo fare in modo che i vertici inizino a interessarsi alla sicurezza informatica e smettano di aspettare che si verifichino eventi negativi.»John Kindervag, responsabile della promozione presso Illumio
«È meglio che vi preparate all’eventualità di un insuccesso», ha affermato Rodriguez. Non è possibile prevedere quale guasto colpirà la vostra infrastruttura, ha aggiunto, quindi «si cerca continuamente di metterla alla prova… spegnendo i sistemi, sottoponendola a traffico reale, simulando diversi scenari, semplicemente sottoponendo continuamente a stress l’ambiente e i team che lo supportano».
Misure concrete per intraprendere il percorso verso l’antifragilità
I relatori dell’ hanno raccomandato di partire in piccolo, concentrandosi su aree specifiche da migliorare e procedendo con iterazioni continue per costruire un approccio alla sicurezza informatica più resiliente e adattivo.
Di seguito è riportata una versione della guida " " (Come creare un'immagine di sistema) con le relative istruzioni disponibili all'indirizzo , integrata con ulteriori dettagli tratti da :
La prossima settimana
Selezioni un obiettivo o un flusso di lavoro, ad esempio un servizio di alto valore o una fonte di incidenti ricorrenti, e definisca da tre a cinque fattori di stress, quali l’interruzione di un servizio dipendente, il failover di una regione, uno scenario di uso improprio delle credenziali, traffico est-ovest anomalo o una “distribuzione non corretta”. Individuate quindi i segnali che vi indicherebbero che il sistema sta scivolando verso una situazione di pericolo.
E review l’ultimo incidente e individuate una soluzione sistemica che potete implementare fin da subito.
Prossimo appuntamento con “ ”: 90 giorni
Si raccomanda di effettuare regolarmente prove di failover facendo transitare traffico reale attraverso i percorsi di backup, in modo che non rimangano inattivi. Automatizzate le operazioni di manutenzione ricorrenti, quali la rotazione dei log, i meccanismi di protezione, il rilevamento delle discrepanze di configurazione e i controlli delle dipendenze. Successivamente, applichino la segmentazione e i limiti basati sul principio del privilegio minimo per ridurre il raggio d’azione dell’attacco. Una volta individuato il primo problema, estenda la risoluzione cercando guasti simili e verifichi la presenza della stessa condizione in tutto l’ambiente, provvedendo poi a porvi rimedio.
i prossimi sei mesi
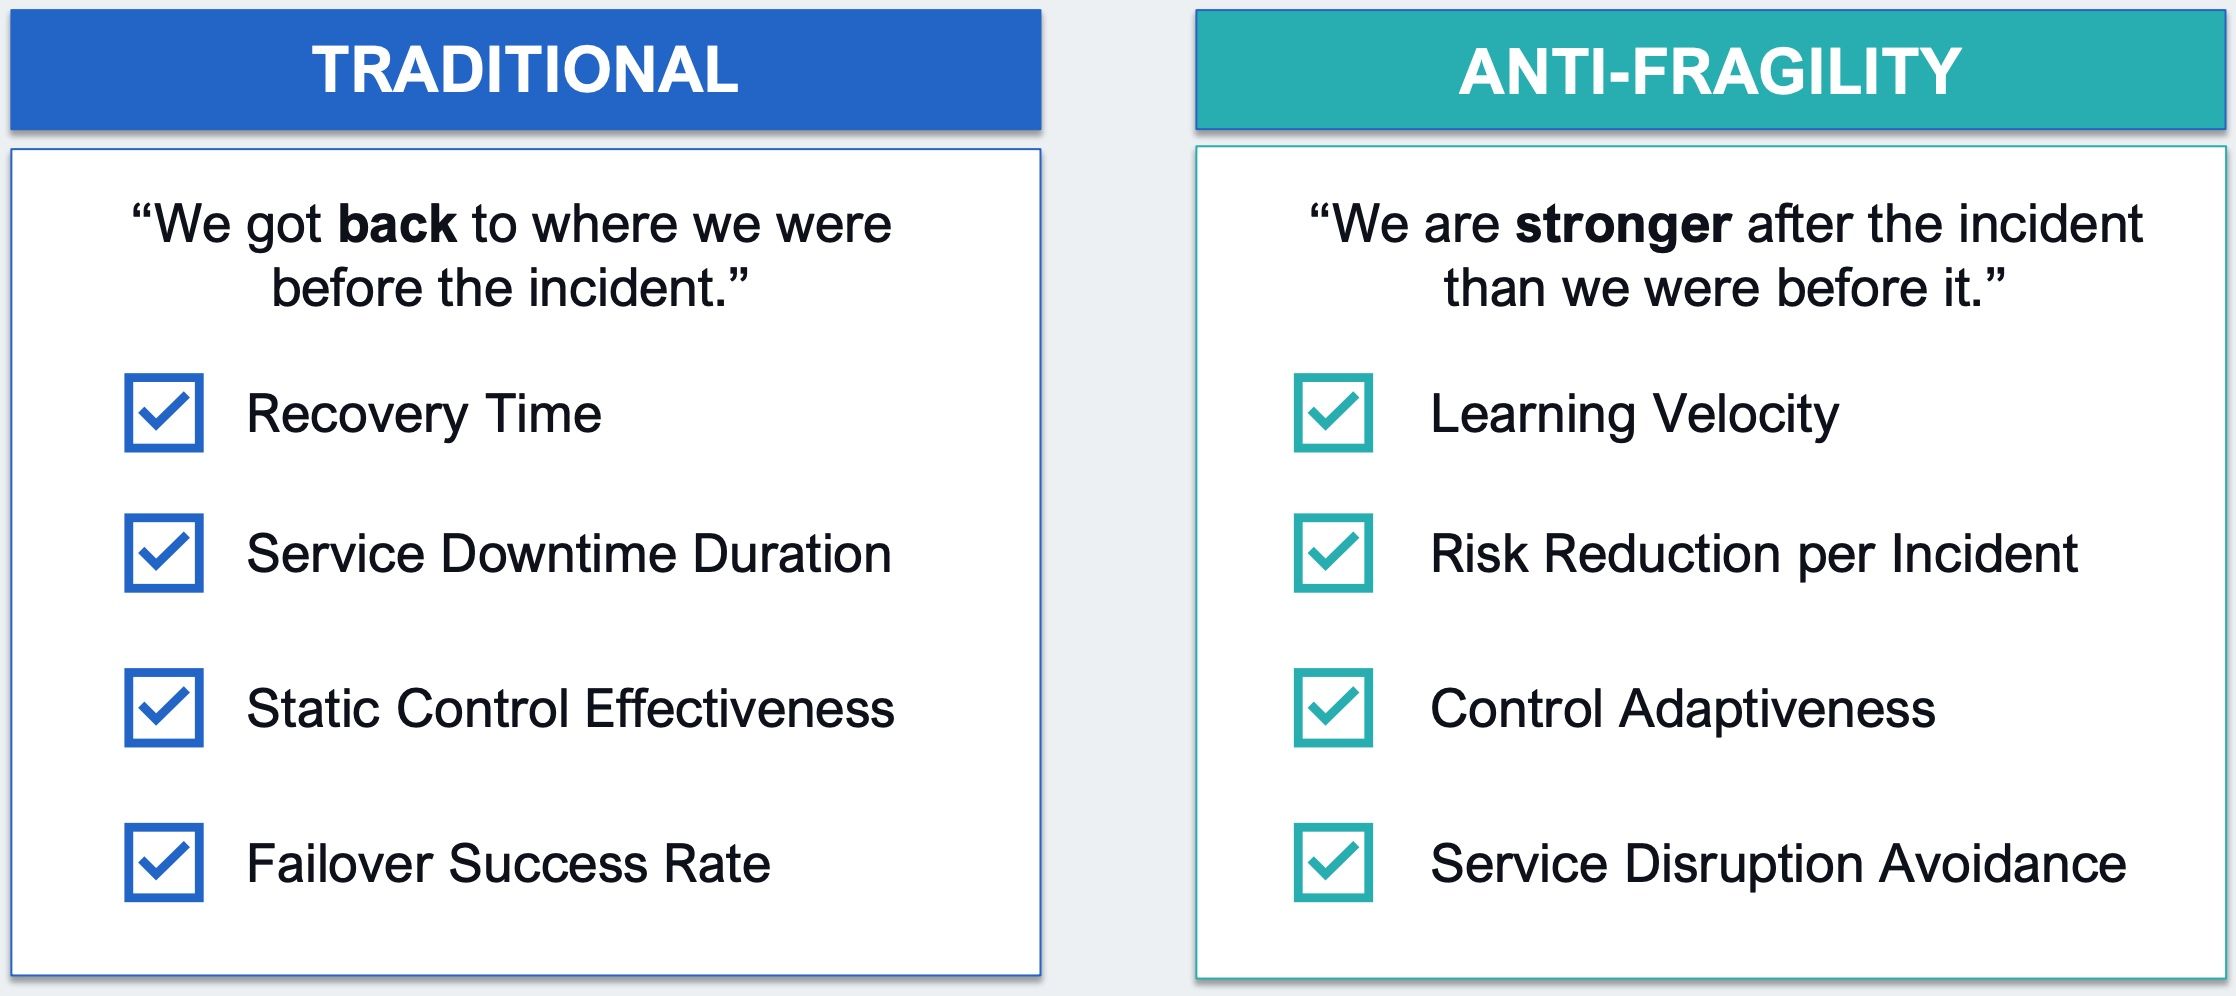
Integri i segnali relativi al comportamento, ai dispositivi, alla rete e ai carichi di lavoro per migliorare il processo decisionale, e non dia per scontato che “autenticato = affidabile”. Istituzionalizzate lo stress controllato programmando simulazioni di situazioni di caos ed esercitazioni “red team” con chiari obiettivi formativi. Monitorare indicatori significativi quali la riduzione delle recidive e la riduzione del rischio sistemico, i tempi di recupero e il contenimento dell’area di impatto. Infine, valorizzate il lavoro silenzioso e spesso poco gratificante della prevenzione e della creazione di soluzioni durature, scoraggiando al contempo la cultura dell’eroismo e la ricerca di colpevoli.
Misurare l’antifragilità
Promuovere una cultura dell’antifragilità
Kindervag e Rodriguez hanno concluso ribadendo una distinzione fondamentale: La resilienza vi mantiene in vita; l’antifragilità cambia la vostra traiettoria.
Quando le organizzazioni considerano lo stress come un segnale, affrontano il fallimento in modo deliberato, applicano quanto appreso a tutti i team e allineano la propria cultura al miglioramento, i programmi di sicurezza non si limitano a sopportare lo stress, ma riescono a dare il meglio di sé sotto pressione.
“ , la sicurezza non dovrebbe limitarsi ad aiutarvi a resistere agli attacchi”, ha affermato Kindervag . ““Questo dovrebbe aiutarLa a rendere sempre più forte col passare del tempo.”

